

不知大家是否有过这样的经历——
刚开始做科研那会儿,我对文献有一种很复杂的情绪:一边担心自己读得不够多,开题时背景铺不厚;一边又害怕自己读得不够细,漏掉关键的方法或结论。结果就是,电脑桌面堆满了PDF,文件夹按日期、按主题、按期刊名层层嵌套,Zotero里的标签越打越多。
但真到写论文需要引用某句话、某组数据的时候,脑子里只剩一个模糊的印象:好像之前读过有一篇的文章里讲过……然后翻遍四五个文件夹都找不到。
后来我慢慢意识到,问题根本不在于读得少,而在于存得方法不对。文献进了电脑,就像掉进了黑洞——能搜文件名,却搜不了正文。我真正需要的,不是再多读一篇,而是让读过的每一篇,都能在需要的时候被精准召回。
直到我养成一个小习惯:
把读过的所有文献,都放进蜜崽的知识库里。
这个操作听起来平平无奇,但核心区别在于——切换检索范围。
以前我用的是全局搜索或本地文件搜索,关键词一输,要么是全网海量结果,要么只能匹配到文件名和摘要。但我真正想搜的,其实是我已经读过的那一小撮核心文献。蜜崽检索的知识库功能,正好提供了一个封闭的、专属的私人学术库。
具体怎么用呢?
我现在的流程是:每读完一篇文献,不管精读还是泛读,都上传到知识库里。不是扔进去就完事,而是带着未来我可能会怎么搜它的意识去存。之后当我需要回忆某个概念、某组数据、或者某个实验设计时,不需要翻任何文件夹,只需要在检索框里把范围限定为"知识库"。
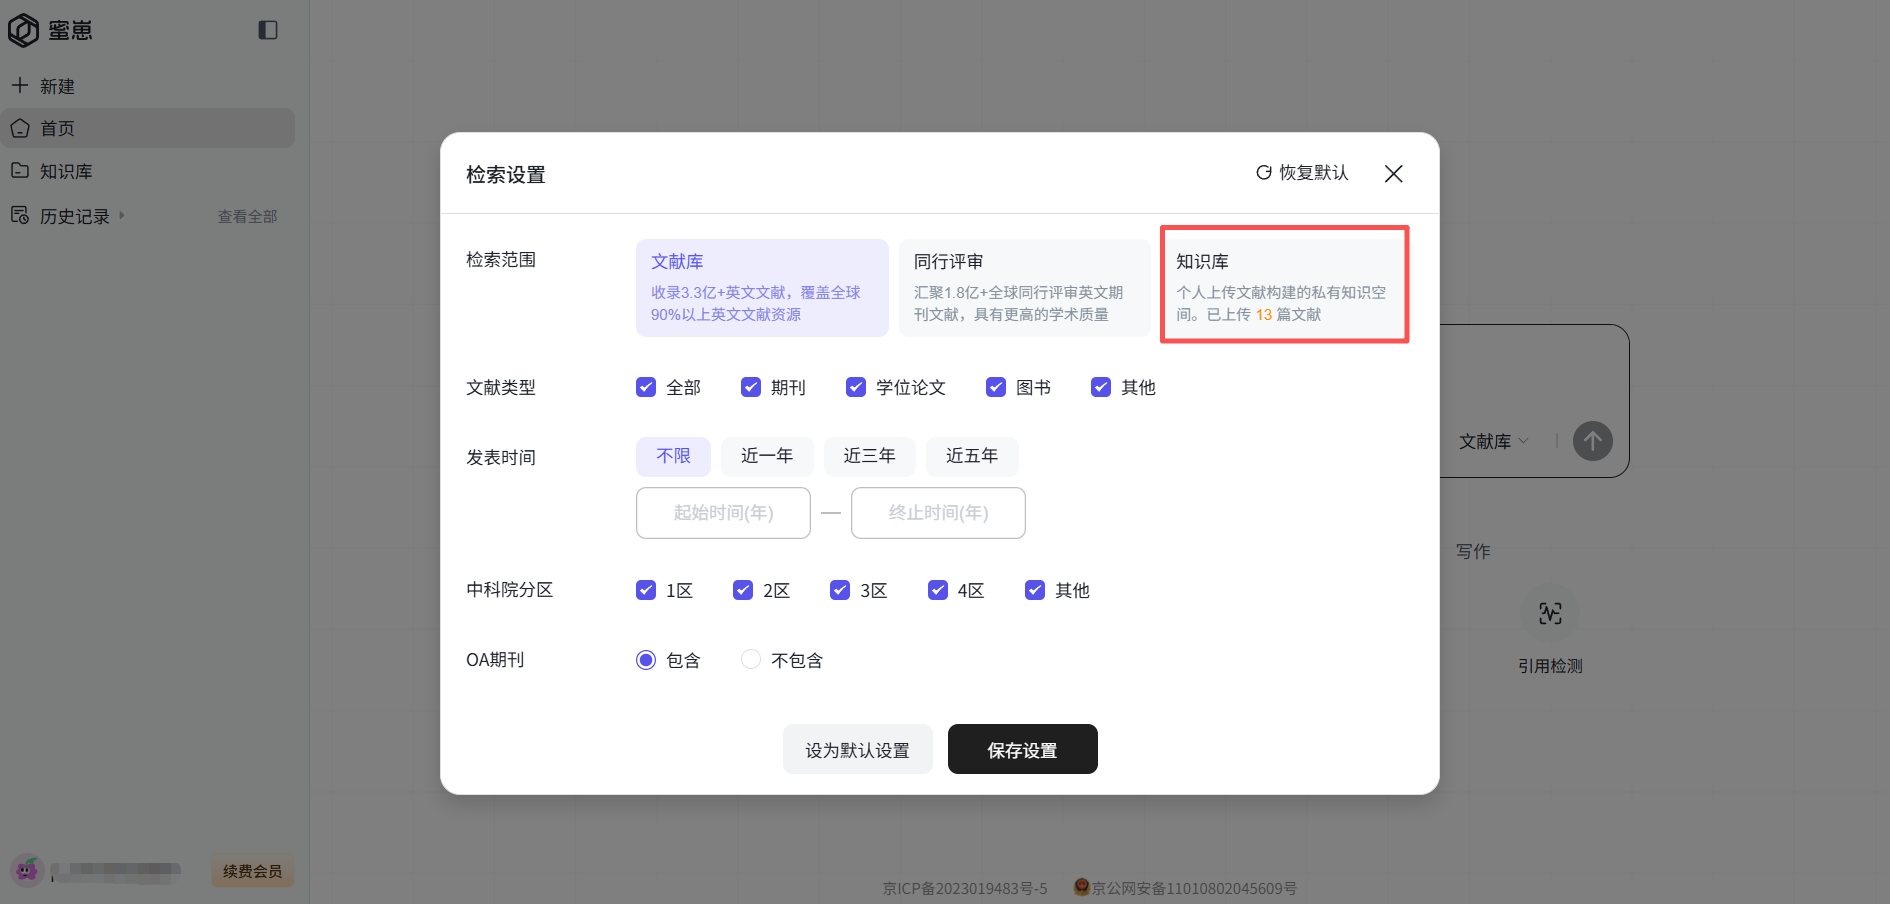
重点来了:
因为检索范围选的是知识库,系统不再只看文件名或摘要,而是从全文维度进行扫读。我可能只记得"拟南芥"和"磷酸化"这两个关键词,完全不记得是哪篇文章里的——没关系,知识库会把所有包含这两个词的段落全部捞出来,而且每一段后面都带着原文出处,点一下就能跳回原PDF。
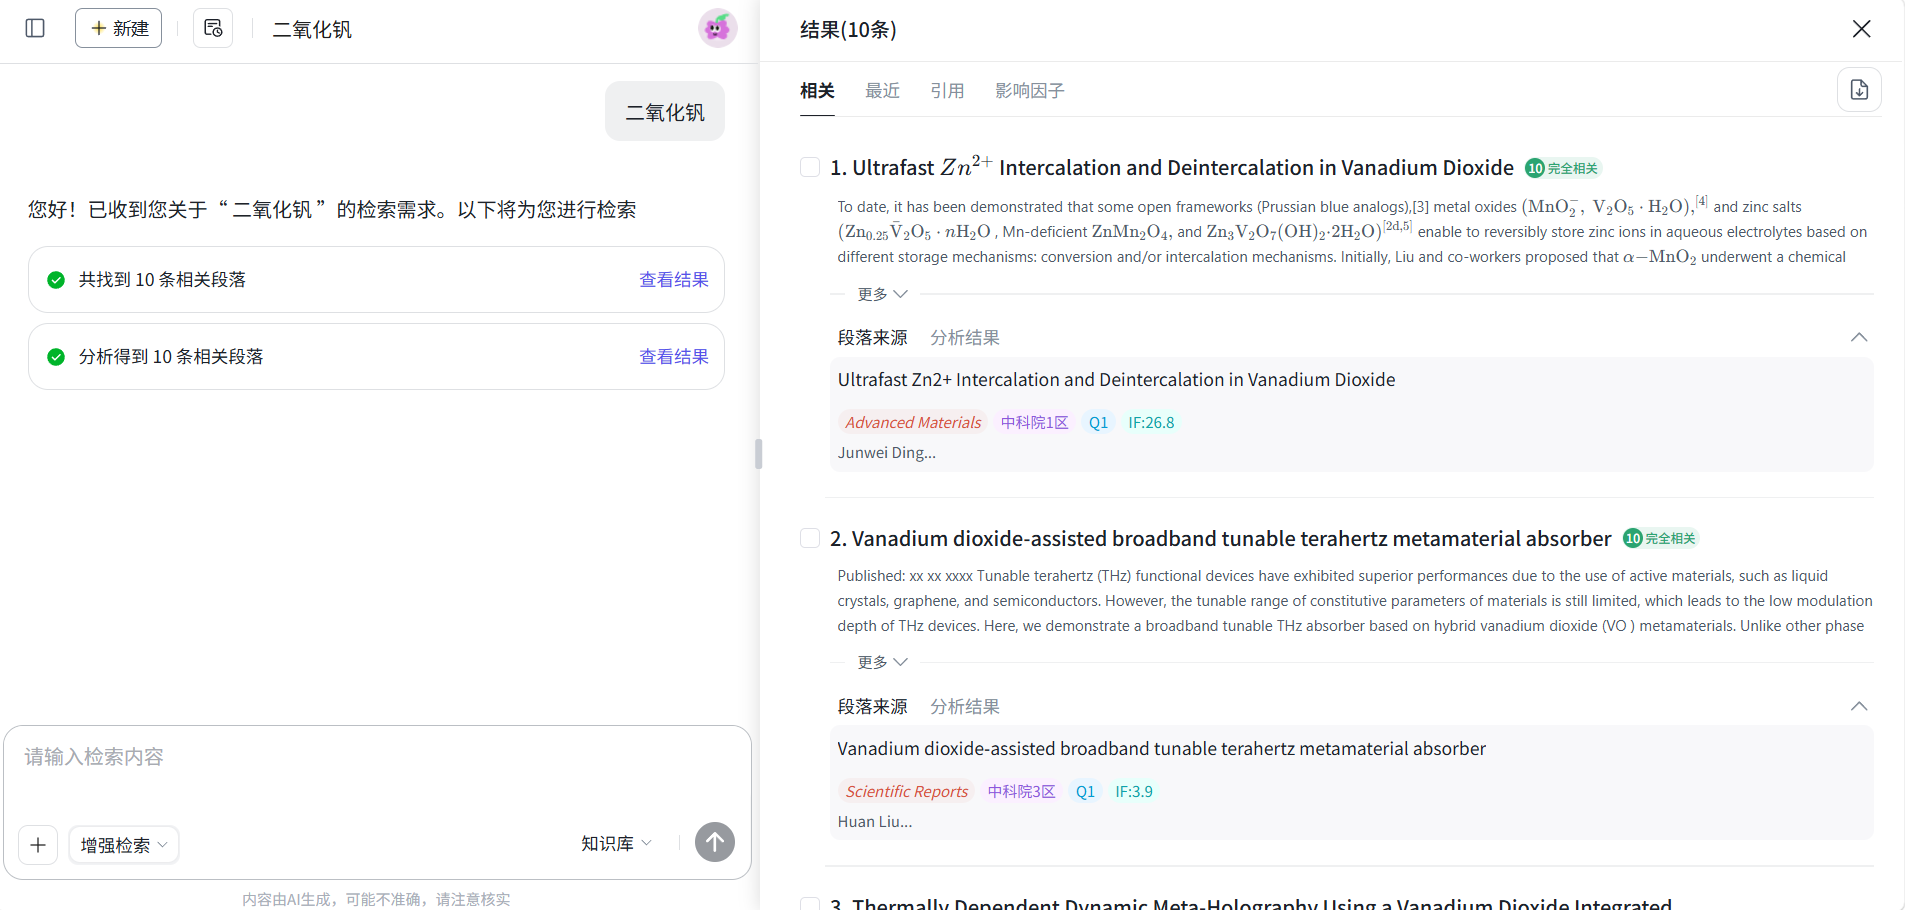
这就相当于给自己配了一个私人学术搜索引擎。我不需要记住每篇文章的每一句话,我只需要记住我读过它,剩下的交给检索。
这个习惯给我带来的最大改变,其实是心理层面的。
以前我总有一种不敢的焦虑——每篇文献都觉得以后可能会用到,于是越积越多,越读越乱。但现在我很清楚,知识库是一个可信的后备箱。我不需要强迫自己记住所有细节,只要确保入库的时候存对了地方,需要时就能检索找到。


